发布:2026-09-29(周二 · 知识库线 KB2)| 渠道:官网首发 → 公众号次发改写版 → 知乎 / 百家号改写 | 产品线:AI 原生知识库(P0)
本文比的不是两款产品,而是同一套知识库的两种部署形态(私有化部署 / 云端部署)
这是企业客户问得最多的一个问题,也是被回答得最潦草的一个。
先把对比的对象说清楚,免得越聊越乱:本文比的不是两款产品,而是同一套知识库的两种部署形态——装在你自己的环境里(私有化部署),还是跑在服务商的云上(云端部署)。知识库还是那个知识库,变的只是它跑在哪、谁运维、算力谁出。
常见的答案有两种。一种来自做私有化的厂商:“上私有化部署吧,数据放在自己机房才安全。”另一种来自云端服务商:“放云端就行,我们都加密的。”
两种都不算错,但都把一件事说窄了:它们默认了「安全 = 位置」,好像数据放在谁的硬盘上,就决定了它安不安全。
这个默认,才是大多数人算错账的起点。
01 先把这两个词定义清楚
“私有化部署”和“云端部署”经常被当成两个阵营来吵。但既然要比,就得先确认比的是同一件事——同一套知识库,系统和数据放在谁的环境里、由谁运维。
| 对比项 | 知识库 · 私有化部署 | 知识库 · 云端部署 |
|---|---|---|
| 系统跑在哪 | 企业自己的机房 / 自有云环境 | 服务商托管的多租户云 |
| 数据存在哪 | 企业边界内 | 服务商云上,按租户隔离 |
| 算力谁出 | 企业自建(含模型推理算力) | 服务商提供 |
| 运维、升级、容灾 | 企业自己承担(或委托第三方) | 服务商负责 |
| 谁能看到你的数据 | 由你自己的权限系统决定 | 由租户隔离 + 你的发布操作决定 |
请注意最后一行:这两种部署形态都能做到“私有”,也都可能做到“不私有”。
把服务器锁在自己机房,但全公司都能随意调取客户档案——这不叫私有;部署在云端,但按租户隔离、不用于训练、导入不等于公开——这在效果上就是私有的。位置不决定可见性,权限才决定。
所以真正该问的,从来不是“本地还是云端”,而是两句:
- 我的数据,谁能看到;
- 我想让它被看到的时候,能不能放出去。
后面所有的账——成本账、安全账、获客账——都是从这两句里长出来的。
02 私有化部署,到底贵在哪
先把这笔账算清楚,不然没法谈选择。
很多人以为私有化部署就是“买几台服务器,把系统装上”。真做起来是两笔成本:
| 组成 | 要做什么 | 成本性质 |
|---|---|---|
| 产品私有化 | 系统部署、运维、升级、容灾、专人值守 | 一次性投入 + 长期人力 |
| 模型私有化 | 自建推理算力:GPU、集群、机房、电力 | 硬件成本极高,是主要成本项 |
关键点在下半张表。AI 知识库不是传统的 OA 或 ERP——它要跑模型。模型要推理就有算力开销,而算力是要用硬件堆出来的。这也是它和普通软件私有化最大的区别:你买的不只是一套系统,是一套算力。
看一组 2026 年的公开测算:一套 8 卡 H200 的生产集群,硬件一次性投入约 32 万美元;按三年折旧,加上电力与冷却(约 +30%)和 1.5 名工程人力,年度总拥有成本(TCO)约 55.2 万美元 [1]。
更值得注意的是它的成本结构:工程人力约占年度 TCO 的 65%,GPU 硬件反而是较小的那一笔 [1]。所以业内那句行话很准——买硬件看起来是采购决策,实质上是一次招聘决策。
再算盈亏平衡点:单卡部署大约需要 3,900 美元/月 的 API 用量才划得来;8 卡生产集群这个数字要接近 46,000 美元/月 [1]。也就是说,如果你的实际用量远低于这条线,私有化部署就是纯亏。
另一份分析给出了同样的提醒:判断本地部署是否划算,关键变量不是硬件价格,而是利用率——GPU 一旦闲置,本地化的账立刻崩掉;而且只有放到 4 年的 TCO 视角上比较才是诚实的,只看 12 个月会系统性低估云 [2]。
举一个具体的例子
假设一家 50 人的制造企业,想把三类东西放进知识库:
- 产品手册、工艺说明、售后 FAQ;
- 报价体系、客户档案、供应商条款;
- 一份核心配方与几份签了保密协议的合同。
如果笼统地决定“上私有化部署”,就要为第三类那么几份文件,把整套算力环境买下来、养起来。为一柜子文件建一栋楼——这就是大多数企业私有化决策的真实写照。
所以我们对企业客户的建议一向是直白的:除非你有明确的强合规或涉密要求,否则不要为了“安全感”三个字去上私有化部署。 那笔钱花在别处,回报高得多。
03 一个反直觉的数据:出事的企业,缺的不是机房
如果说成本是“不该冲动”的理由,那下面这组数据就是“该做什么”的答案。
IBM《2025 年数据泄露成本报告》调研了 2024 年 3 月至 2025 年 2 月间全球 600 家遭遇泄露的机构,其中关于 AI 的部分 [3]:
| 发现 | 数据 |
|---|---|
| 报告遭遇 AI 模型或应用安全事件的组织 | 13% |
| 这些出事的组织中,缺乏适当 AI 访问控制的比例 | 97% |
| AI 安全事件造成数据泄露 / 业务中断的比例 | 60% / 31% |
| 尚未建立 AI 治理政策、或仍在制定中的组织 | 63% |
| 影子 AI(未经审批的 AI 工具)带来的额外平均泄露成本 | +67 万美元 |
把这张表读一遍,结论其实很刺眼:那些真出了事的企业,缺的不是本地机房,是访问控制。
97% 这个数字说明——知识库部署在哪不是决定性的,谁能访问才是。一家把服务器锁在机房、但全员都能随意调取客户数据的公司,并不比一家权限收紧的云端用户更安全。
同期报告还显示,全球数据泄露平均成本为 444 万美元,平均识别与遏制周期 241 天(九年最低);而通过内部检测发现漏洞的机构,平均少损失 90 万美元 [3][4]。内部检测能力,同样不取决于服务器位置。
04 正确的问法:按数据类型分层放
“该不该私有化部署”没有统一答案,因为它取决于你放的是什么数据。
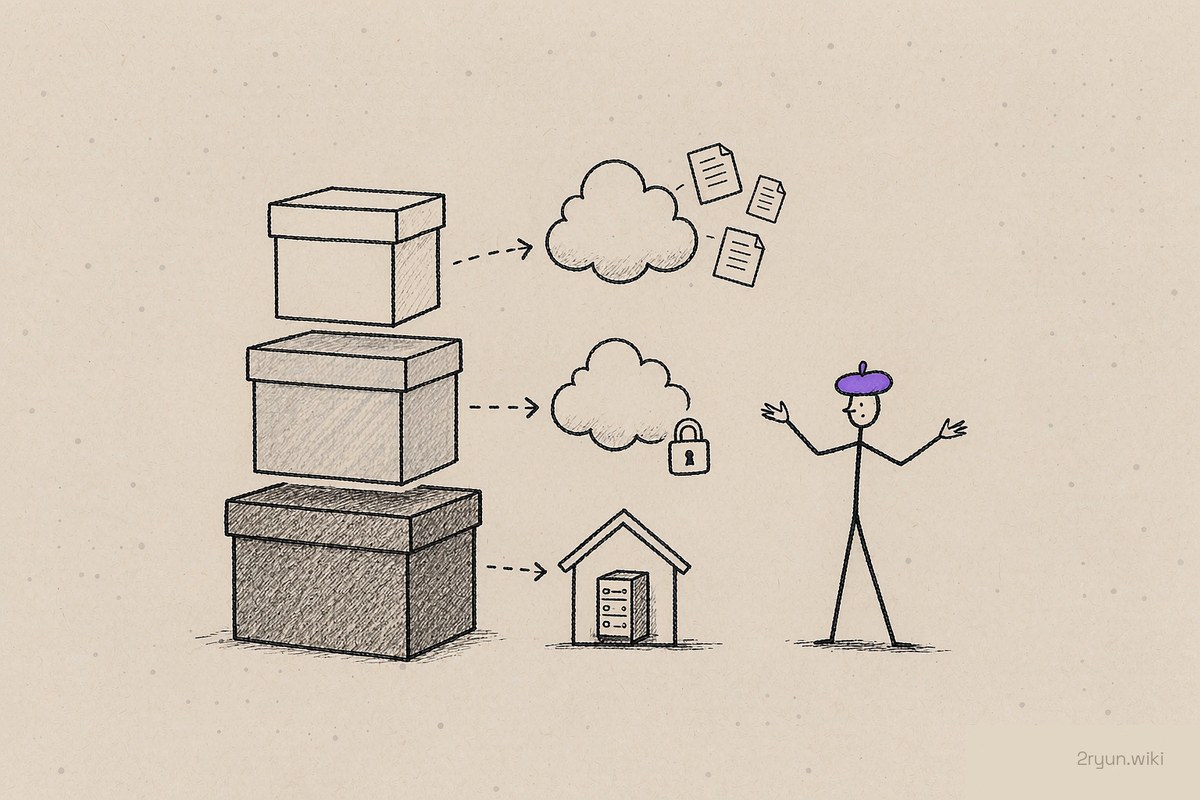
更实用的做法是分层:
| 层级 | 数据类型 | 建议怎么部署 | 为什么 |
|---|---|---|---|
| L1 · 可对外 | 营销内容、品牌资料、产品介绍、公开 FAQ、行业方法论 | 云端部署,并且主动发布出去 | 这类数据的价值就在于被看见。锁在自有环境里,等于放弃搜索与 AI 引用的机会 |
| L2 · 内部可控 | 流程制度、内部手册、培训资料、客户档案、报价体系 | 云端部署,不发布 | 需要随时能检索、能被 AI 答出来,但没有公开的理由 |
| L3 · 强敏感 | 涉密资料、核心算法、受监管数据 | 才考虑私有化部署 | 确有强约束,这个成本才付得值 |
回到那家制造企业:产品手册与售后 FAQ 是 L1,报价与客户档案是 L2,配方与保密合同是 L3。真正需要私有化部署的,只有最后一类——而它往往只占你数据总量的很小一部分。
大多数企业的数据集中在 L2:不需要公开,但也远远没到必须自建机房的程度。
L1 为什么最不该锁起来
还有一层容易被忽略:把 L1 数据锁在自有环境里,损失的不是安全,是获客。
用户找信息的方式已经变了。截至 2025 年 12 月,我国生成式人工智能用户规模达 6.02 亿,普及率 42.8%,半年增长 141.7% [5]。第三方监测显示,AI 搜索流量占比已突破 52%,传统搜索流量同比下降 18.8%;用户在 AI 搜索中进行品牌查询、产品对比、消费决策的比例,一年内从 34% 升至 57% [6]。
你的产品介绍、行业方法论如果不以公开网页的形式存在,它们在 AI 的回答里就是不存在的。这跟安不安全没关系,是“有没有”的问题。
而这一类数据,只有放在云端、并且能被发布出去,才有意义——这是私有化部署天然做不到的部分。
05 云端部署,也可以是“私有”的
到这里,就该把那个被说窄的词掰回来了。
先把我们自己的情况说清楚:2Ryun 主体是一套云端部署的知识库,这是我们推荐的默认形态。 私有化部署版本我们也可以提供,但它是“例外”而不是“标配”——需要针对企业的实际情况做针对性的配置和调试,接入成本高于线上版本。而在绝大多数情况下,你真正需要的不是一座机房,而是一个部署在云端、但依然私有的知识库。
我们说一个知识库是“私有的”,指的是三件事:
- 数据是你的——平台不拿你的内容去训练模型;
- 只有你能用——别的账号、别的团队看不到你的库,除非你主动授权;
- 你想公开才公开——把文档导进去,不等于它变成了公开页面。要生成网页、发布、绑定域名,必须由你主动操作。你不点,它就不出去。
这三条讲的都是归属与可见性,跟部署在哪没关系。
技术上怎么做到:多租户隔离
在云端部署的架构里,“你的数据别人看不到”靠的是分租户机制:
- 每个账号 / 团队是一个独立租户,数据在租户维度隔离,租户之间互不可见;
- 跨租户的访问在鉴权层就被阻断,而不是靠“大家自觉”;
- 协作范围由你自己设定,可以精细到某一篇文档。
也就是说,你拿到的是一个在数据库与租户这一层就隔离好的知识库:数据落在你自己的租户里,平台不训练、不代你公开;你要公开哪一篇,由你说了算。
(顺带澄清一个容易混的词:我们说“数据库层面的私有化”,指的是隔离发生在数据与租户这一层,是一种实现机制的描述——它不改变产品形态,你的东西依然是一套知识库。)
这就是我们说的——严格意义上,这是数据库层面的私有化。它和“把服务器搬回机房”是两条不同的路,通向的是同一个结果:除了你授权的人,没人看得到。
06 什么情况下才真的需要私有化部署
不绕弯子,两种情况:
- 合规或监管明确要求数据不得离场(部分行业、涉密项目);
- 数据类型高度集中在 L3,且体量大到长期租赁算力反而不划算。
除这两类之外,对绝大多数企业来说,私有化都是“相对的”——通过隔离、鉴权、不训练、可导出这些技术手段达到数据安全,比物理隔离划算得多,也更容易维护。
(如果你确实属于这两类:2Ryun 也可以提供私有化部署版本,但需要针对企业的实际情况做针对性的配置和调试,接入成本高于线上版本——所以值得先确认自己是不是真的属于这两类。)
至于个人用户,我们的建议更直接:不要考虑私有化部署。 成本太高,完全没有必要。个人场景里真正需要的是“能存、能找、能带走”,而不是自己养一套推理集群。
07 给你三个判断问题
下次再有人跟你谈“要不要私有化部署”,先问这三个:
- 这批数据,是必须锁死的,还是其实希望被客户看到的?(很多企业把 L1 数据也锁进了自有环境,白白放弃了获客)
- 如果上私有化部署,模型算力谁出?(只谈软件部署、不谈模型算力的方案,都是没算完的账)
- 我能不能随时把数据完整带走?(这一条比“部署在哪”更重要——导出能力决定了你有没有退路)
三个问题答完,答案通常自己就出来了。
数据放哪,不是一个安全题,是一道分类题。
FAQ
引用来源
本文引用的第三方数据均注明出处,供交叉核验;数据口径以来源方为准。
- Devox Software 《On-premises LLMs for Enterprise: Hardware, TCO, and Strategy》(2026)——8× H200 集群 CapEx 约 32 万美元、三年期年度 TCO 约 55.2 万美元、工程人力约占年度 TCO 65%、盈亏平衡点约 3,900 美元/月(单卡)至 46,000 美元/月(8 卡集群)。 https://devoxsoftware.com/blog/on-premises-llms-for-enterprise-hardware-tco-and-strategy (厂商技术指南,中等可信)
- VDF AI 《On-Premise LLM Cost Comparison 2026》——本地部署是否划算取决于利用率;应以 4 年 TCO 视角比较。 https://vdf.ai/resources/on-premise-llm-cost-comparison-2026/ (厂商分析,中等可信)
- IBM 《2025 年数据泄露成本报告》官方中文解读页——600 家机构样本;13% 组织遭遇 AI 模型/应用安全事件、其中 97% 缺乏 AI 访问控制、60% 致数据泄露、31% 致业务中断、63% 尚无 AI 治理政策、影子 AI 额外 +67 万美元;全球平均 444 万美元、平均周期 241 天。 https://www.ibm.com/cn-zh/think/x-force/2025-cost-of-a-data-breach-navigating-ai (IBM 官方,高可信)
- IBM 新闻室(台北,2025-08-04)同上报告中文发布稿——补充 60% 致数据泄露 / 31% 致业务中断、影子 AI 额外 +67 万美元、内部检测发现漏洞的机构平均减少 90 万美元损失。 https://taiwan.newsroom.ibm.com/2025-08-04-IBM-2025-AI-AI (IBM 官方,高可信)
- CNNIC 《第 57 次中国互联网络发展状况统计报告》(2026 年 2 月发布)——生成式 AI 用户 6.02 亿、普及率 42.8%、半年增长 141.7%(截至 2025 年 12 月)。转载报道: https://www.sgpjbg.com/labels/zhongguohulianwangluofazhanzhuangkuang.html (官方数据、第三方转载,高可信/转载来源)
- QuestMobile / 易观分析 数据经 IT之家转载报道——AI 搜索流量占比突破 52%、传统搜索同比下降 18.8%(QuestMobile,2026-04);AI 搜索月活 6.8 亿、品牌查询/对比/决策比例由 34% 升至 57%(易观,2026-06)。 https://www.ithome.com/1/002/134.htm (媒体转载二手数据,中等可信,仅作趋势参考)
2Ryun(第二现实)是面向知识工作者与中小企业的 AI 原生知识库:文档存进去,知识自动生长;按租户隔离,数据不用于训练、不默认公开,也能一键生成可被搜索与 AI 引用的网页与整站(内置 GEO 优化),免费使用。
👉 2ryun.wiki | 邀请码:RYUN-PWFR-SLSL